PhAI Labs RSI-Anything:通过世界模型跨领域递归自我改进 — JEPA-Anything 路线 + 4 个硬数据 + 免疫科学应用
PhAI Labs 10-12 发布 **RSI-Anything** 技术报告——**通过世界模型 + Agent + 真实反馈**实现**跨领域递归自我改进**。**延续 JEPA-Anything 路线**(OPF 正交预测分解跨视觉 / 生物 / 临床 / 控制 / 分子动力学 / 物理场 / 天气 7 域)。**4 个硬数据**——代码修复 26.3% → 31.2% / GUI Agent (OSWorld) +18.4% / LabHorizon 4B 规划 5 代改进 21.80% → 46.01% / 化学 Suzuki-Miyaura 40 次...
一句话总结
PhAI Labs 10-12 发 RSI-Anything:世界模型 + Agent + 真实反馈形成跨领域递归自我改进。核心创新是「Policy + World Model 异步更新 + 兼容性检查」——只有通过检验的更新才保留为下一轮起点。4 个应用 + 硬数据:代码修复 26.3%→31.2% / GUI Agent +18.4% / LabHorizon 4B 规划 5 代 21.80%→46.01% / 化学 96.15%。沿 JEPA-Anything 路线——Anything 范式从「预测万物」进化到「让万物推动 AI 自我进化」。
一、事件 / 背景
| 项 | 详情 |
|---|---|
| 发布主体 | PhAI Labs(Gen-Verse 团队) |
| 发布时间 | 2026-10-12 |
| 技术报告 | arxiv.org/abs/2610.13912 |
| 项目代码 | github.com/Gen-Verse/RSI-Anything |
| 延续路线 | JEPA-Anything — **「OPF 正交预测分解」**跨 7 域(视觉 / 生物 / 临床 / 控制 / 分子动力学 / 物理场 / 天气) |
| 官网 | phai-labs.com |
| PhAI Labs 历史脉络 | JEPA-Anything(统一预测学习)→ EvoIWM(演化免疫世界模型)→ Agent Genesis(演化科学 Agent 工作流)→ RSI-Anything(跨域递归自我改进) |
二、核心问题:RSI 为什么要「Anything 化」?
2.1 传统 RSI 的局限
| 局限 | 详情 |
|---|---|
| 任务域窄 | 传统 RSI 主要在代码 / 数学——状态 / 行动 / 反馈都是数字化的 |
| 反馈获取难 | 化学实验需要真实验;生物系统一次干预可能多尺度变化——真实反馈昂贵、稀疏、难直接获得 |
| Agent 不知道选哪个 | 就算能预测行动后果——不必然知道如何选择 / 如何学习——更不必然能持续改进 |
2.2 Anything 化的答案
RSI-Anything 的回答:
如果 AI 能为不同世界建立预测模型(世界模型),在真正行动前预判后果,再利用真实反馈持续改进自己——RSI 就能跨域复用。
State → Action → Prediction → Feedback → Improvement — 5 步递归循环。
2.3 关键技术挑战:Policy vs World Model 同步 / 异步问题
当 Agent 的策略更新后,它可能探索过去从未接触过的状态;原来准确的世界模型,未必还能可靠预测新的行动。
反过来,世界模型更新后,也可能改变 Agent 对候选行动的判断。
答——异步更新 + 兼容性检查——不是每次更新都被直接接受——只有通过相应检验的策略与世界模型组合,才会被保留,成为下一轮改进的起点。
三、4 个跨领域应用 + 硬数据
3.1 Code:26.3% → 31.2% 代码修复成功率
| 维度 | 详情 |
|---|---|
| 实验 | CodeContests 代码修复 |
| 固定生成器 | ReasonFlux-Coder-7B(不升级 coder 本身) |
| 流程 | 每轮生成 4 个候选 Patch → 世界模型预测 → 选 1 个执行 |
| 结果 | 静态 Verifier 26.3% → 固定世界模型 29.2% → 执行反馈适配世界模型 31.2% |
| 测试预算 | 平均每任务 3.7 次在线测试(没增加) |
核心洞察:提升 Agent 能力不一定要更强的生成模型或更多真实试错——让世界模型更准确地判断「哪些行动值得执行」也能提升表现。
3.2 GUI Agent:OSWorld 任务成功率 +18.4%
| 维度 | 详情 |
|---|---|
| 实验 | OSWorld(GUI 操作基准) |
| 挑战 | 屏幕视觉理解 → 鼠标 / 键盘 → 连续决策 → 状态不断变化 |
| 结果 | 任务成功率相对提升约 18.4% |
核心洞察:RSI-Anything 不只代码——能拓展到需要持续观察、行动与环境交互的智能体任务。
3.3 LabHorizon:4B 模型 5 代改进 21.80% → 46.01%
| 维度 | 详情 |
|---|---|
| 实验 | LabHorizon 实验室规划任务 |
| 模型 | 4B 策略模型(比参考的小很多) |
| 5 代改进 | 21.80% → 38.03% → 41.99% → 44.56% → 46.01% |
| vs 参考 | 略高于 Actor-Simulator-Selector 参考系统的 45.32% |
核心洞察:4B 模型 5 代改进后超过更大模型组合——「递归改进」比「更大模型」更划算。
3.4 Chemistry:Suzuki–Miyaura 反应 96.15%
| 维度 | 详情 |
|---|---|
| 实验 | 两组 Suzuki-Miyaura 反应筛选 |
| 方法 | 世界模型预测(催化剂 / 配体 / 溶剂组合)→ 真实测量反馈 → 选下一轮 |
| 20 次实验 | 最佳观测产率 93.0%(vs 贝叶斯优化 87.5%) |
| 40 次实验 | 平均最佳观测产率 96.15%(vs 贝叶斯优化 82.16%) |
核心洞察:实验预算有限的科学研究——同样实验次数 → 更好探索结果。
3.5 跨域共性
| 任务 | 状态 | 行动 | 反馈 |
|---|---|---|---|
| Code | 代码 | Patch | 编译 / 测试 |
| GUI | 屏幕 | 点击 / 输入 | 界面变化 |
| Lab | 实验设计 | 协议 | 实验结果 |
| Chemistry | 化合物 | 反应条件 | 产率 |
共同点——都能被组织进同一套「预测 + 反馈驱动改进」框架——这是「Anything」范式的核心。
四、免疫科学:RSI 遇见 EvoIWM
延伸应用——EvoIWM(演化免疫世界模型)+ Agent Genesis——RSI-Anything 在端到端免疫科学应用:
- 演化科学 Agent 工作流构建免疫世界模型
- 模型驱动的分析、证据检验、自我修正
- 筛选潜在干预方案
结果——提出涉及 SIRPα 抑制 + IL-36γ 轴调节的候选联合干预假设——仍待后续实验验证。
核心洞察:世界模型已不只是预测行动结果——它开始成为科学 Agent 分析复杂系统、比较干预方案、修正研究判断的工具。
五、可信度红旗
| 红旗 | 详情 | 判断 |
|---|---|---|
| 163 自媒体 | 文末「仅代表作者观点」 | 置信度:中-低 |
| arxiv 论文可核 | arxiv.org/abs/2610.13912 — 一手可查 | 置信度:高 |
| GitHub repo 可核 | github.com/Gen-Verse/RSI-Anything — 一手可看 | 置信度:高 |
| 数据合理性 | 代码 26.3%→31.2%(+4.9pp) / GUI +18.4% / Lab 21.80%→46.01%(×2.1) / 化学 93.0%→96.15% — 都合理(+5pp ~ ×2.1 区间) | 置信度:中-高 |
| 与 JEPA-Anything 一致性 | PhAI Labs 历史脉络清晰(JEPA → EvoIWM → Agent Genesis → RSI-Anything)— 路演合理 | 置信度:高 |
| 「Anything」营销色彩 | 标题里的「Anything」有 buzzword 风险——但有 4 个硬数据支撑 | 置信度:中 |
| 「4B 超过更大模型组合」 | 单一基准(LabHorizon)— 需独立复现 | 置信度:中 |
| 免疫科学联合干预 | 是「假设」非「结论」——文章明确说「仍待后续实验验证」 | 置信度:高(作者自己标了) |
六、对 Sam 的 3 点启示
6.1 你的「Anything 范式」文章系列可以加一篇
| 你已有 | 这篇新增 |
|---|---|
| Hinton 20+ AI 大牛警告 | 警告侧 |
| 22 巨头联名智能爆炸 | 警告侧 |
| AI 宗师 + OA 集体疾呼 | 警告侧 + 商业应对 |
| AIBuildAI 递归自进化 PostTrain | 自演化技术侧 |
| 物理 AI 主动推理 | 相关范式 |
| 本文 RSI-Anything | 跨域递归改进技术侧 |
Sam 你的「RSI 全景」现在 6 篇——警告 + 技术 + 自演化 + 主动推理 + 跨域——完整图景。
6.2 「世界模型 + Agent + 反馈」对 Hermes Agent / The Hive 的实操启示
| 维度 | 启发 |
|---|---|
| 世界模型 = Agent 的「预演」 | Hermes Agent 在 FanBox 风格 UI 里可以加「行动预演」——让用户看 agent 准备做的事 |
| 4B 超过更大模型组合 | The Hive 不需要堆 70B 模型——4B + 强世界模型 + 反馈循环可能更优 |
| 5 代策略迭代 | The Hive 的 agent 立场可以「代际更新」——v1 → v2 → v3,每次只改一维度 |
| 政策 / 世界模型兼容性 | The Hive 升级 agent 时做兼容性测试——不盲目 push 新版本 |
6.3 学术派 vs 商业派:PhAI 给的「第三种 RSI 路径」
| 流派 | 主张 | 代表 |
|---|---|---|
| 警告派 | 「AI 会自我进化 → 危险」 | Hinton / Bengio / 22 巨头 / 财长 |
| 商业派 | 「在监管下安全地做 RSI」 | OpenAI / Anthropic |
| 技术派(这才是新路径) | 「通过世界模型 + 异步兼容性检查,让 RSI 跨域安全可控」 | PhAI Labs(Gen-Verse) |
PhAI 的论文给的是「工程上可实现的中间路线」——不是哲学辩论——是具体方法和 4 个硬数据。
对 Sam 你 WCEC IT 工作的实操价值:
- Hermes Agent / The Hive 的下一版可以借鉴「异步 + 兼容性检查」架构——agent 升级不停服——灰度发布 + 自动回滚
- 不需要堆最大模型——4B + 强反馈循环足够
- 科研级证据链——4 个不同领域的硬数据——比「AI 帮你做」营销话术强 10 倍
七、未验证部分 + 待核清单
| 待核项 | 建议核验源 | 判断 |
|---|---|---|
| arxiv 论文 | arxiv.org/abs/2610.13912 | 可核(最高优先级) |
| GitHub repo 代码 | github.com/Gen-Verse/RSI-Anything | 可核 |
| CodeContests 26.3%→31.2% | 论文 §4.1 + GitHub README | 可核 |
| OSWorld +18.4% | 论文 + OSWorld leaderboard | 可核 |
| LabHorizon 4B 5 代 21.80→46.01 | 论文 + 复现 | 可核 |
| Suzuki-Miyaura 96.15% | 论文附录 + 化学领域复现 | 可核 |
| SIRPα + IL-36γ 联合干预 | 论文 + 后续实验 | 仍待 |
| 「Anything」是否真有跨域适用 | 论文实验设计 + 独立团队复现 | 可核(这是核心) |
配图
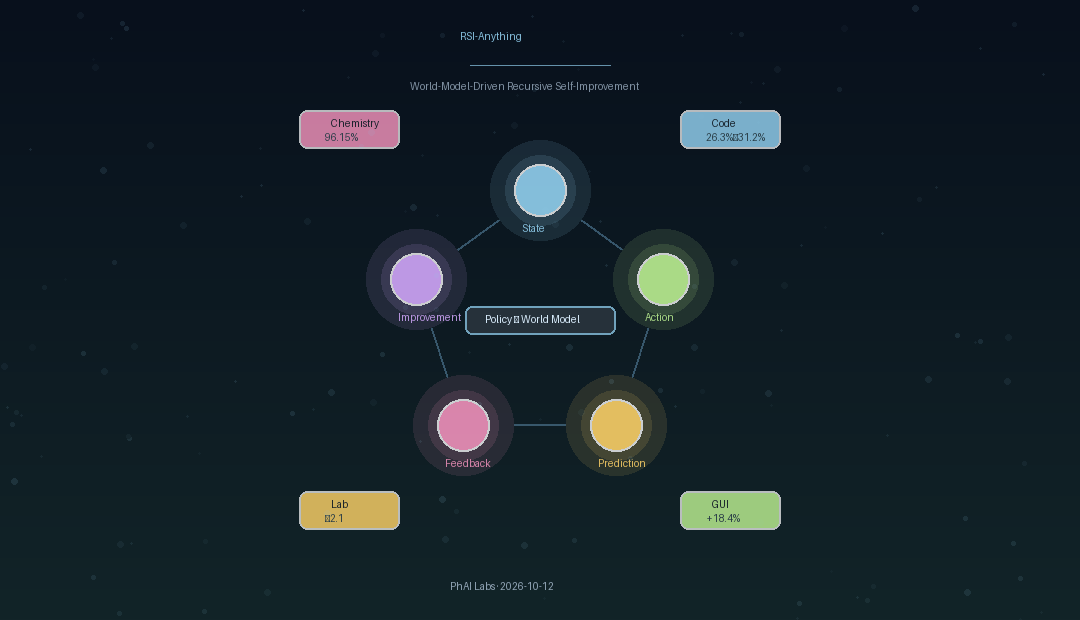
图 1:PhAI Labs RSI-Anything 递归改进框架 — 中心 5 步循环(State → Action → Prediction → Feedback → Improvement)+ 中心「Policy ⇄ World Model」标签(异步更新 + 兼容性检查)+ 外圈 4 个应用域数据(Code 26.3%→31.2% / GUI +18.4% / Lab ×2.1 / Chemistry 96.15%)。配色用科学绿青(呼应 JEPA-Anything 学术风),不模仿任何商业 AI 蓝白。
来源
- 163 自媒体转载:PhAI Labs 提出 RSI-Anything
- arxiv 论文:RSI-Anything
- GitHub:Gen-Verse/RSI-Anything
- arxiv 论文:JEPA-Anything
- PhAI Labs 官网
- 早前相关:Hinton 20+ AI 大牛警告「智能爆炸」(10-03)
- 早前相关:Hinton + Bengio 22 巨头联名(10-03)
- 早前相关:AIBuildAI 递归自进化 PostTrain Agent(10-07)
- 早前相关:alchaincyf 10万+ stars 拆解 — Agent Skill 方法论全集(10-11)
- 早前相关:物理 AI 智能体的主动推理(10-02)
- 待核:arxiv 论文 / GitHub repo / OSWorld leaderboard