突发!OpenAI 立下 28 天军令状:不上新就全员重置额度
⭐ **Codex 负责人 Tibo 在 X 公开 28 天承诺**:⭐ **每天要么交一项对大多数 Codex / Work 用户明显有用的改进,要么做一次完整额度重置**。⭐ **4 类重点**:⭐ 简化产品 / 效率换用量 / 突破性功能 / 新模型。⭐ **背景**:⭐ **GPT-6.1 Sol(9-29 DevDay)服务端负载过高 / 速度骤降** + ⭐ **9-22 Opus 5.5 发布后 90 分钟 OpenAI 才追上** + ⭐ **GPT-6.1 Sol 在最大推理等级下仍打不过 Opus 5.5**。
一句话总结
⭐ Codex 负责人 Tibo 在 X 公开 28 天承诺:⭐ 每天要么交一项对大多数 Codex / Work 用户明显有用的改进,要么做一次完整额度重置。⭐ 4 类重点:⭐ 简化产品 / 效率换用量 / 突破性功能 / 新模型。⭐ 背景:⭐ GPT-6.1 Sol(9-29 DevDay)服务端负载过高 / 速度骤降 + ⭐ 9-22 Opus 5.5 发布后 90 分钟 OpenAI 才追上 + ⭐ GPT-6.1 Sol 在最大推理等级下仍打不过 Opus 5.5。⭐ 用户反馈:⭐ 100 美元 Pro 一周撑不满 / Claude Opus 5.5 效率更高 / 额度更耐用。⭐ Grok Bot 团队 Lauren Tan:”⭐ only you can win this battle” + 上月 ⭐ 2,500 PR + 72 小时直播搭了一家公司。⭐ 社区:⭐ Token Gremlin 直接说:”⭐ 如果 28 个改进里没有一个真打过 Opus 5.5,对能力用户没意义”。⭐ 核心矛盾:⭐ 额度可反复送,能力欠账得靠模型补。
一、⭐ 28 天军令状 ⭐
“OpenAI 给自己下了一道军令状,28 天,天天交作业,交不出就拿额度来赔。”
⭐ Codex 负责人 Tibo X 帖原文:
“未来 28 天,每天要么交出一项对大多数 Codex 和 Work 用户明显有用的改进,要么做一次完整的额度重置。改进之旅正式开启。”
⭐ 外号:“重置哥” / “义父”(过去几个月 Codex 的额度重置十回里有九回是他发帖宣布的)。
二、⭐ 4 类重点 ⭐
| # | 类别 | 详情 |
|---|---|---|
| ⭐ 1 | 简化产品 | “用户反馈已经很明确了,大家想要东西变得更简单” |
| 2 | ⭐ 效率换用量 | 用更少 token 出更多结果 |
| 3 | ⭐ 突破性功能 | 全新能力 |
| ⭐ 4 | ⭐ 新模型 | 直接对标 Opus 5.5 |
三、⭐ 触发事件链 ⭐
| 时间 | 事件 |
|---|---|
| ⭐ 2026-09-22 | ⭐ Anthropic 发布 Opus 5.5 ⭐ —— OpenAI ⭐ 90 分钟后才发 GPT-6 Sol 跟上 —— ⭐ “秒级卷” |
| ⭐ 2026-09-29 | ⭐ DevDay 推 GPT-6.1 Sol ⭐ —— ⭐ 价格打到 Astra 1/5 性价比扳回 |
| ⭐ 2026-10-02 | Tibo ⭐ 道歉 + 宣布次日全局重置(DevDay 服务端负载过高 / 速度骤降) |
| 2026-10-03 | Tibo ⭐ 还在追查 Pro 500 档没吃到重置的问题 |
| ⭐ 2026-10-04 | ⭐ Tibo 28 天军令状 |
“OpenAI 这阵子一直在补同一个窟窿:用户付了钱,总觉得不够用,也搞不清到底用到哪去了。”
⭐ Agent 时代特有的窟窿 ⭐
“你在 Codex 里敲一行需求,后台可能启动一整条流水线 —— 模型写代码要花 Token,读上下文要花,维护记忆、生成摘要、调度子 Agent 统统要花。”
“极端情况下,一个跑飞的任务就能吃掉你一周 70% 的额度。”
四、⭐ 用户反馈 ⭐
“GPT-6.1 Sol 虽然缩小了差距,但在最大推理等级下,Opus 5.5 依然守住了天花板。”
“更让 Codex 用户心态失衡的是体感:不少人 100 美元档的 Pro,一周撑不满;而用 Claude 的人纷纷表示,Opus 5.5 效率更高,额度明显更耐用。”
⭐ 社区情绪 ⭐
“在 Tibo 那条定调帖下面,已经有高赞回复直说:「功能我不在乎,只要一个能打过 Opus 5.5 的模型。」”
“也有人更干脆:「我准备转去 Claude 和 Grok 了」。”
五、⭐ 隔壁的火药味 ⭐
⭐ Grok Bot 团队 ⭐
⭐ Lauren Tan 调侃 Tibo:
“期待很快再见,来自 The Ship Company 的更多发布。”
⭐ Tibo 反向挑战:
“我挑战你也这样做。”
⭐ Lauren 回复:
”⭐ only you can win this battle。”
⭐ Grok Bot 的产能 ⭐
“Lauren 上个月交了 2,500 个 PR,还做了 72 小时直播挑战,用 Grok Bot 从零搭了一家公司。”
“在 Tibo 忙着按重置按钮的时候,隔壁两家都在用产品本身说话。”
六、⭐ 社区核心观点 ⭐
⭐ Token Gremlin ⭐
“28 个改进里如果没有一个模型真正打过 Opus 5.5,对在乎能力的用户来说意义不大。”
⭐ 吐槽党 ⭐
“按钮放大,字体换换,让用户养个宠物,给 Dots 换个新颜色 —— 这些当然也算「改进」嘛。”
⭐ 关键质疑 ⭐
“什么叫「对大多数用户有明显帮助」,Tibo 没给定义。”
“按钮变大算不算?用量面板优化算不算?哪些档位能吃到重置?原帖都没说。”
七、⭐ 给 Sam 的启示 ⭐
| # | 启示 | 落地 |
|---|---|---|
| ⭐ 1 | ⭐ Agent 时代的”额度焦虑”是行业级痛点 —— OpenAI / Anthropic 都没解决 | Sam 做 Hermes Agent 时,⭐ 优先考虑 token 用量透明度面板 ⭐ —— 不让用户”花到哪去了都不知道” |
| ⭐ 2 | ⭐ Opus 5.5 在最大推理档位仍领先 GPT-6.1 Sol ⭐ —— ⭐ 智能 + 效率双指标都是 Anthropic 强项 | ⭐ Sam 的研究/写作流:⭐ Opus 5.5 优先(⭐ 如果它是 Anthropic 主力产品,⭐ Hermes Agent 应深度支持) |
| ⭐ 3 | ⭐ “产品本身说话”才是真护城河 —— 2,500 PR + 72 小时直播 vs 重置按钮 | ⭐ OpenClaw 的承诺应以”功能上线”为准,⭐ 不是”承诺”为准 |
八、⭐ 战略意义 ⭐
⭐ 这次军令状揭示 AI 行业进入”主动承诺 + 兑现压力”阶段:
| 维度 | 旧模式 | 新模式 |
|---|---|---|
| ⭐ 竞争策略 | ⭐ 闭门发布 + PR 包装 | ⭐ 公开承诺 + 28 天限时交付 |
| ⭐ 用户期待 | ⭐ 每几个月一次大版本 | ⭐ 每天看改进 |
| ⭐ 失败兜底 | ⭐ 沉默或降价 | ⭐ 直接重置额度 |
⭐ 对 OpenAI 的真正考验:
“额度可以反复送,能力上的欠账,得靠模型来补。”
“28 天后,准备转去 Claude 的用户,大概会得出结论 —— OpenAI 到底有没有拿出一个值得自己留下来的模型。”
配图
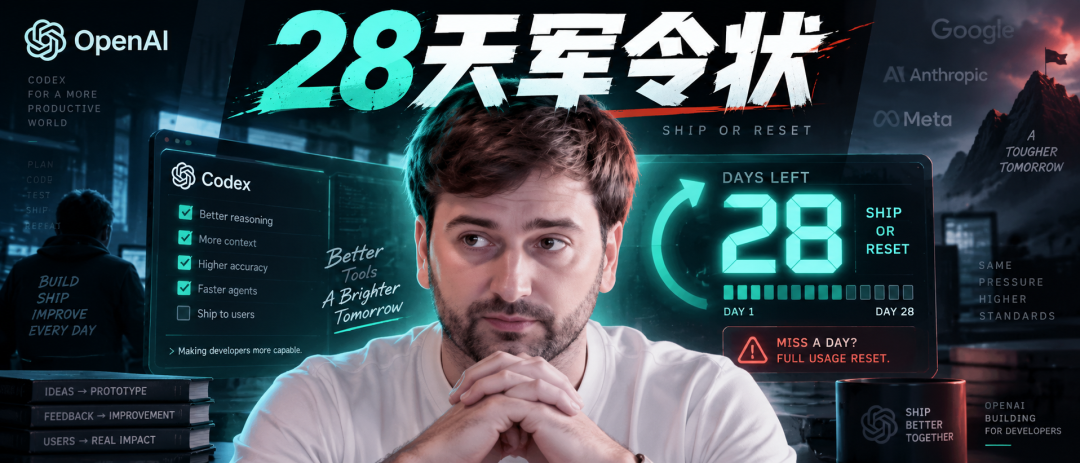
图 1:Tibo 28 天军令状 —— 每天交改进或重置额度(新智元 · 2026-10-05)