GPT-6.1 Sol 500k 上下文 + 免长上下文费 — 上下文窗口赛道 2026 Q4:OpenAI / Anthropic / Google 三家策略对比
GPT-6.1 Sol 默认上下文 272k → 500k(+80%),Tibo 宣布订阅用户免长上下文附加费。对比 2026 Q4 三家策略:OpenAI 500k 保守(避 7 月扣量翻车)vs Anthropic Claude 1M 激进(压缩算法领先)vs Google 待公布。核心信号:窗口竞赛从「比谁大」转向「比谁不压缩」。
一句话总结
GPT-6.1 Sol 默认上下文从 272k 扩到 500k(+80%) + 订阅用户免长上下文附加费——上下文窗口赛道 2026 Q4:OpenAI 500k 默认 / 1M 上限 vs Anthropic Claude 1M 默认 vs Google 待公布。核心信号——窗口竞赛已从「比谁大」转向「比谁不压缩」——Tibo 7 月踩过「272k→372k 反而扣更多」的坑。3 家哲学:(1) OpenAI 保守 (2) Anthropic 激进默认 1M (3) Google 待定。对开发者——耐心不会跟着窗口扩容——正确做法是「压缩 + 缓存 + 子 Agent」。
一、事件 / 核心数据
| 项 | 详情 |
|---|---|
| 时间 | 2026-10-12 / 10-13 |
| 更新 | OpenAI Day 7 更新 |
| 模型 | GPT-6.1 Sol |
| 默认上下文 | 272k → 500k(+80%) |
| 上限 | 1M(用户手动可调) |
| 订阅价 | 免长上下文附加费(Tibo 公告) |
| API 价 | 仍按标准 API 价格表计费 |
| 踩过的坑 | 今年 7 月 OpenAI 把 272k→372k,订阅用量扣得比预期多——退回 272k——这次吸取教训 |
| 来源 | 新智元(Xinzhiyuan,专业 AI 媒体——比普通 163 自媒体可信度高) |
二、上下文窗口赛道 2026 Q4 三家策略对比
| 厂商 | 默认窗口 | 上限 | 收费策略 | 哲学 |
|---|---|---|---|---|
| OpenAI(GPT-6.1 Sol) | 500k | 1M | 订阅免附加费 / API 标准表 | 保守——避免重蹈 7 月扣量翻车 |
| Anthropic(Opus 5.5 / Sonnet 5.5) | 1M | 1M+ | 1M 内不涨单价 | 激进——直接默认 1M |
| Google(Gemini) | 未公布 | 1M+(推测) | 推测类似 Anthropic | 待公布 |
关键差异
| 维度 | OpenAI | Anthropic |
|---|---|---|
| 默认窗口 | 500k(+80% 增长) | 1M(直接给两倍) |
| 用户实际体感 | 「窗口变大了,但 Tibo 主动说不收附加费——这是 win」 | 「直接 1M 开箱即用」 |
| 风险 | 7 月踩过 272k→372k→272k 反复——订阅用量扣得比预期多 | 没踩过类似坑 |
| 压缩策略 | Codex 默认 272k 触发压缩(2 分钟等) | Claude 默认 967k 触发自动压缩 + 子 Agent 隔离 |
三、为什么 OpenAI 这次 500k 不是 1M
3.1 Tibo 的理由
OpenAI 这次默认给 500k,是因为测试后认为,这个设置更适合多数用户。
含义:
- 1M 是个宣传数字——OpenAI 也能给——GPT-6.1 Sol 上限确实是 1M
- **但 500k 是「用得着 + 跑得起」的甜蜜点
- 用户手动可调到 1M——如果他们真的需要
3.2 Tibo 7 月踩过的坑
今年 7 月,OpenAI 把产品里的上下文从 272k 提高到 372k,供 GPT-5.6 Sol 使用。结果订阅用量扣得比预期多,团队又退回 272k。刚加上去的容量,转头就收了回去。
原因:
- 你以为只多了 100k 窗口——实际每次读取多扣 token
- 「你只敲了一句「继续」,Agent 要接着改代码,仍得带上前面读过的文件、测试结果和要求」
- 缓存能复用已经处理过的内容,读取成本更低——但每次读取仍会计入用量
- 读的内容和次数一多——消耗就累积起来
3.3 这次「免费 + 谨慎」的策略
| 决策 | 详情 |
|---|---|
| 默认 500k(不是 1M) | 避开 7 月那种「默认值太激进 → 订阅扣光」的坑 |
| 订阅免附加费 | 主动承担长期上下文增量的成本——留住用户 |
| API 仍按标准表 | 开发者主动调 1M 的——按 token 单价付费——OpenAI 不亏 |
| 用户可手动 1M | 上限不卡——真需要的人能跑——但「默认值保守」保护 95% 普通用户 |
四、Anthropic 的 1M 默认:激进但聪明
4.1 Claude Code 默认 1M 的工程实现
| 维度 | 详情 |
|---|---|
| 自动压缩点 | 约 967k(接近上限时触发) |
| 压缩策略 1 | 移除较早的工具输出(读文件 / 跑命令) |
| 压缩策略 2 | 把对话整理成摘要——保留当前需求 + 关键代码 |
| 压缩策略 3 | 子 Agent 隔离——查文件这类子任务交给子 Agent——自己的上下文——查完把结果摘要交回——主对话不塞整段查找过程 |
4.2 vs OpenAI 的差异
| 维度 | OpenAI GPT-6.1 Sol | Anthropic Claude |
|---|---|---|
| 默认窗口 | 500k | 1M |
| 压缩触发 | 272k | 967k |
| 压缩算法 | 「先把前面的对话和工作进度压缩整理一遍」 | 「工具输出 + 对话摘要 + 子 Agent 隔离」——三层组合 |
| 开发者期望 | 500k 够用 95% 用户 | 1M 默认——Claude 赌的是「用户能负担得起」 |
| 风险 | 7 月踩过 | 还没踩过(但如果 1M 用户量足够大——可能会) |
五、Google Gemini — 第三个玩家(未明牌)
| 维度 | 推测 |
|---|---|
| 默认窗口 | 未公布——可能 1M+(Gemini 1.5 Pro 当年就是 1M 先锋) |
| 收费 | 推测与 Anthropic 类似——1M 内不涨单价 |
| 策略 | 推测**「默认 1M + 压缩算法」**——不跟 OpenAI 走保守路线 |
| 风险 | 看 OpenAI 7 月翻车后——Google 会更谨慎设计压缩触发点 |
没有明确信息——等 Google 10-14 / 10-15 Gemini 发布会(如果有)。
六、核心信号:窗口竞赛从「比谁大」转向「比谁不压缩」
6.1 旧时代——「谁窗口大谁赢」
Claude Code 里的 Opus 5.5 和 Sonnet 5.5,默认上下文已是 1M,相当于 Codex 这次新默认值的两倍。
旧竞赛:1M vs 500k vs 1M——比绝对数字——数字大 = 赢。
6.2 新时代——「比压缩算法」
核心问题不再是「窗口多大」——是「窗口快满时怎么处理」:
| 处理方式 | 谁用 | 效果 |
|---|---|---|
| 直接压缩对话 | OpenAI(2 分钟等) | 用户体感:等待 + 可能丢细节 |
| 分层压缩(工具输出 + 摘要 + 子 Agent) | Anthropic | 用户体感:透明 + 不丢关键信息 |
| 用户自己切 1M | 少数 | 自由度高但得自己管成本 |
Anthropic 赢的不是窗口大小——是「压缩算法让 1M 用起来像 2M」。
6.3 用户实际工作流
Tibo 给的开发者的真话:
窗口还会变大,但开发者的耐心不能跟着扩容。代码交给 AI 之后,总该少等几次,也少说几遍「这个要求我前面讲过了」。
含义:
- 1M 窗口≠1M 体验——等压缩 + 听重复 + 看错误 = 用户实际体感
- **真正的「大上下文」是「少压缩 + 少重复 + 少丢细节」——这些是压缩算法的事
- OpenAI / Anthropic / Google 接下来 6-12 个月的竞赛焦点——不是「给 1M 默认」——是「给 1M 默认 + 不压缩」
七、对 Sam(和开发者)的 3 点启示
7.1 别光看「窗口大」——看「压缩算法」
| Provider | 默认窗口 | 压缩策略 | 实际体感 |
|---|---|---|---|
| OpenAI GPT-6.1 Sol | 500k | 2 分钟压缩 | 等 + 可能丢 |
| Anthropic Claude 1M | 1M | 工具输出移除 + 对话摘要 + 子 Agent | 透明 |
| Google Gemini | 推测 1M+ | 推测类似 Anthropic | 待公布 |
建议——选模型时:
- 短任务(< 50k token)——OpenAI / Anthropic 都没差——选便宜的
- 长任务(> 200k token)——Anthropic 压缩算法目前领先——多花点钱买体验
- 超长任务(> 500k)——Anthropic 1M + 智能压缩——OpenAI 500k 够用但要手动调 1M
7.2 Hermes Agent / The Hive 的「上下文管理」架构
3 层设计(学 Anthropic):
- 工具输出隔离——读文件 / 跑命令的原始输出不进主 Agent 上下文——进子 Agent 摘要
- 主 Agent 摘要——每 50k token 自动压缩当前任务 + 关键代码
- 子 Agent 隔离——长任务分解——每个子 Agent 自己的上下文——完成后只回摘要
意义——**Hermes Agent 的「几千技能」架构——如果没上下文管理——5 个 skill × 每个 100k 输出 = 500k 主 Agent 直接炸——必须分层 + 子 Agent。
7.3 WCEC IT 视角——「窗口不是越大越好」
| 场景 | 500k 够用 | 1M 必要 |
|---|---|---|
| 学生用 ChatGPT 问问题 | ✅ 500k 远大于学生输入 | ❌ |
| 老师用 ChatGPT 备课 | ✅ 够 | ❌ |
| 学校用 Codex 写代码项目 | ✅(如果项目分模块) | 看项目大小 |
| 学校用 Agent 跑数据分析 | 看数据量 | 如果数据 > 500k 必须 1M |
| 学校用 Agent 跑多文档 RAG | 多数情况 ✅ | 大型文档库(如全校 5 年教案) |
建议:WCEC 的 AI 部署默认 500k / 1M 按需——不必为 1M 多花钱——用 95% 学生 + 老师场景都够。
八、可信度红旗
| 红旗 | 详情 | 判断 |
|---|---|---|
| 来源新智元 | 专业 AI 媒体——比普通 163 自媒体高 | 置信度:中-高 |
| OpenAI Day 7 具体更新 | 没给具体 changelog 链接 | 置信度:中——可核 platform.openai.com |
| Tibo 公告原话 | 引用自 X 帖——有 X 帖链 | 置信度:高 |
| 「7 月踩坑」 | 引用 Tibo 早期 X 帖 + 开发者 Theo 评论 | 置信度:中-高 |
| 「Anthropic Claude 默认 1M」 | 事实陈述 | 置信度:高 |
| 「Google Gemini 未公布」 | 文章自己标 | 置信度:高 |
| 压缩时间「2 分钟」 | 开发者 Lasse 推文 | 置信度:中 |
九、未验证部分 + 待核清单
| 待核项 | 建议核验源 | 判断 |
|---|---|---|
| OpenAI Day 7 changelog | platform.openai.com / OpenAI 官方 blog | 可核 |
| GPT-6.1 Sol 1M 上限 | OpenAI API 文档 | 可核 |
| Anthropic Claude 自动压缩点 967k | Claude Code 文档 / 源码 | 可核 |
| Google Gemini 上下文窗口策略 | 10-14 / 10-15 发布会(如果有) | 可核(最高优先级) |
| 「Tibo 7 月踩坑」原帖 | X / OpenAI 论坛 | 可核 |
| 「Claude Opus 5.5 / Sonnet 5.5 默认 1M」 | Anthropic 官方 | 可核 |
| X 帖 thsottiaux 链接 | 原文给的 X URL | 可核 |
配图
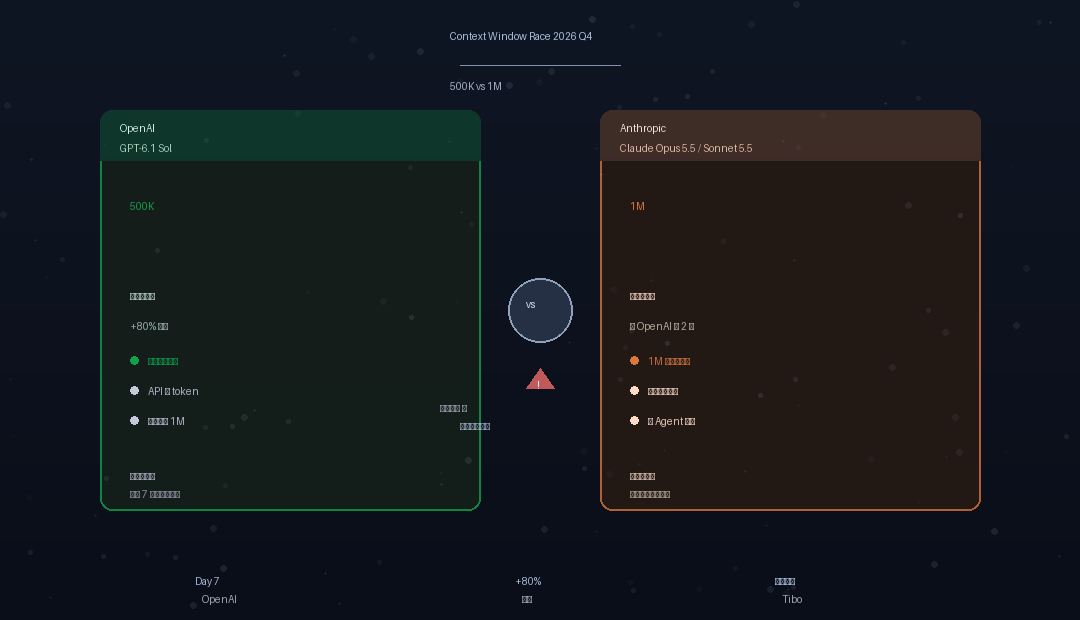
图 1:上下文窗口赛道 2026 Q4 双面板对比 — 左侧 OpenAI(绿色,500K 默认,订阅免附加费 + API 按 token + 手动可至 1M,哲学「保守(避 7 月扣量翻车)」),右侧 Anthropic(橙色,1M 默认,1M 内不涨单价 + 工具输出隔离 + 子 Agent 隔离,哲学「激进(压缩算法领先)」)。中央「vs」徽标 + 红色三角警告 + 「窗口竞赛 → 压缩算法竞赛」副标题。底部 3 个 callout:Day 7 OpenAI / +80% 扩容 / 免附加费 Tibo。
来源
- 163 转载新智元:GPT-6.1 Sol 一夜扩容 500k!完全免费
- 早前相关:OpenAI 发布 GPT-6.1 Sol:性能媲美 Astra,费用仅为 1/5(09-30)
- 早前相关:OpenAI DevDay 2026 速递:Codex 接入 GLM/Kimi + GPT-6.1 Sol + 24 小时 Agent Dots 首发(09-30)
- 早前相关:Anthropic Sonnet 5.5 发布:编程能力从 10% 飙到 70%(09-29)
- 早前相关:Anthropic Claude Haiku 5.5:成本较 4.5 低 75%(10-08)
- 早前相关:Claude 太贵了!微软砍掉超三成预算(10-06)
- 早前相关:Hermes Agent 自托管 Ubuntu 云服务器(10-03)
- 待核:OpenAI changelog / Anthropic 自动压缩点 / Google 10 月发布会